中间激活张量的一生:显存曲线为什么是锯齿状的,以及 token 与 d 到底是什么
前一篇 为什么一条 32k 请求能瞬间打爆显存 把显存拆成了三类:常驻水位(权重)、线性累积(KV Cache)、瞬时峰值(中间激活)。
这篇往下再挖两层。两个问题分别直击推理内存管理和 Transformer 数据流的本质,分开讲。
第一部分:为什么「峰」会随着小批次结束降下去
结论先行:中间激活张量是「算完即弃」的一次性工作区。它们的生命周期不是「整条 prompt 处理完」,而是「当前这个算子算完」——张量一旦不再被任何变量引用,PyTorch 的缓存分配器就会立刻把它的显存归还回池子,供下一个算子或下一个 chunk 复用。
1.1 一个 QKᵀ 分数矩阵的一生
用时序图直观看注意力块内一个分数矩阵的完整生命周期:
1 | 时间 → |
对应到显存占用曲线:
1 | 显存占用 |
引用计数消失,显存立即归还。 所以「峰值」从不是一条持续抬高的水位线,而是每个算子执行时瞬时锯齿的最高点。
1.2 真正不随算子结束释放的,只有三类
对比着看就清楚了:
| 类别 | 生命周期 | 释放时机 | 量级(Llama-3-70B, 32k, FP16) |
|---|---|---|---|
| 模型权重 | 整个服务期间常驻 | 服务下线 | ~140 GB |
| KV Cache | 请求存续期间常驻 | 请求结束 / 被 PagedAttention 逐出 | ,每 token ~0.33 MB |
| 中间激活张量 | 单个算子执行期间 | 下一个算子消费完即释放 | ,峰值由单步 token 数决定 |
表格最右一列正好接上前一篇的结论:前两类决定水位,第三类决定峰值。
而 chunked prefill 降低的正是第三类的 ——把单步处理的 token 数从 32k 压到 4k,每个锯齿的高度就矮了,但锯齿的形状(产生 → 消费 → 释放)完全不变。
1.3 一个容易被忽略的工程细节
释放的是 PyTorch 缓存分配器视角下的「可复用块」,cudaMalloc 层面不一定立刻还给操作系统——这正是 caching allocator 存在的意义:官方原话是 allows fast memory deallocation without device synchronizations,避免频繁 cudaMalloc 的昂贵开销。
但从下一个算子的视角看,那块显存已经可以用了。这也解释了为什么:
nvidia-smi显示的占用往往高于torch.cuda.memory_allocated()——官方文档原话:the unused memory managed by the allocator will still show as if used in nvidia-smi- 用
memory_allocated()(真实张量占用)与memory_reserved()(分配器管理的总量)能区分这两者 - 调
torch.cuda.empty_cache()能让nvidia-smi的读数下降,但不会增加可供 PyTorch 使用的显存(官方原话:empty_cache() releases all unused cached memory… the occupied GPU memory by tensors will not be freed)
三个容易踩的限定条件:
- 「无引用」指的是无引用底层 Storage,不是无引用张量对象。 一个 view 或 slice 会保活整块底层存储——从大张量上切一小片存下来,那块大显存就释放不掉。这是显存泄漏的常见来源。
- 循环引用要等 Python 的循环 GC,不是引用计数归零就立刻释放。
- 归还的是分配器 pool,不是操作系统。 想让显存真正还给 OS 需要
empty_cache(),但那通常得不偿失。
第二部分:Token 对应什么维度?d 是什么?
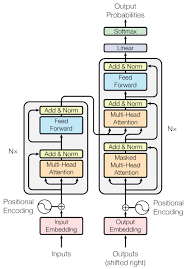
结论先行:进入模型前,token 只是一个整数(词表中的索引);进入模型后,它立刻被 embedding 矩阵查表变成一个长度为 的向量。
(hidden dimension / d_model / residual stream dimension)的含义是「每个 token 的向量表示宽度」,即每个 token 由多少个数字组成。它不是经典意义上的「神经元数量」,更接近「每个 token 的特征数」。
2.1 把整条数据流走一遍
假设 Llama-3-70B(、),prompt 有 3 个 token:
1 | Prompt: "The cat sleeps" |
图中两处关键细节:① K/V 投影的输出宽度是
num_key_value_heads × head_dim = 8 × 128 = 1024,不是 8192——这是 GQA 的作用,也是显存节省的来源;② 注意力分数矩阵带 head 维,写成 而非 。
2.2 三个关键观察
① token 从「整数」到「向量」的身份转换发生在 embedding 层,且一去不回头。
从 embedding 之后到 LM head 之前,张量的形状永远是「token 数 × d」——3 个 token 就是 ,32k 个 token 就是 ,80 层算完形状一直不变(残差流保持维度恒定)。
② 是「每个 token 的表示宽度」,不是神经元数量。
这是很多初学者容易混淆的点:
| 维度 | 它更接近「什么」 | 类比 |
|---|---|---|
| (隐藏维度,如 8192) | 每个 token 的特征向量长度 | 一张特征卡片上有 8192 个格子,每格是一个特征值 |
| FFN 中间维度(如 28672) | 每个 token 经过 MLP 时扩展到的中间单元数 | 这才更像「神经元数量」的概念 |
num_attention_heads(如 64) |
把 切成多少份并行做注意力 | 维/头 |
所以一个 70B 模型的「8192」不是「有 8192 个神经元」,而是「每个 token 在网络里被表示为一个 8192 维向量,这个向量的每个分量都是一个可学习的特征通道」。
真正的「神经元密度」体现在 FFN 中间层——28672 才是每个 token 在 MLP 里被展开成多少个「神经元」式单元。
两点必要的限定(避免把类比当成严格定义):
- 「神经元」是解释性隐喻,不是严格定义。 机制可解释性研究把 FFN 中间层读作「键值记忆」(Geva et al. 2020, arXiv:2012.14913),中间维度可理解为记忆槽位数——但这是一种解读框架,不是架构定义。
- 残差流维度 ≠ 可解释特征数。 由于 superposition(叠加)现象,模型会用 维空间表示远超 个特征。所以「8192 个格子 = 8192 个特征」只是量级直觉,不是精确对应。Anthropic 的数学框架(A Mathematical Framework for Transformer Circuits)把残差流描述为各组件「read from / write to」的公共通道,这个「通道宽度」的解释比「特征数」更准确。
③ 回到内存公式。
现在可以精确理解「」这个形状占多少显存了(、FP16、Llama-3-70B):
| 张量 | 算式 | 量级 |
|---|---|---|
| Q 投影 | ≈ 0.54 GB | |
| K 投影(GQA) | ≈ 0.067 GB | |
| V 投影(GQA) | ≈ 0.067 GB | |
| FFN 中间态(SwiGLU 的 gate + up 两份) | ≈ 3.76 GB | |
| ↳ 若逐元素乘积张量也被物化(第三份) | ≈ 5.64 GB | |
| 注意力分数矩阵 | ≈ 137 GB |
最后一个数字完美解释了为什么「32k 无 chunked prefill 会瞬间 OOM」——不是权重不够放,不是 KV Cache 撑爆了,而是那一个 的注意力分数张量,单独一个就比整张卡的显存还大。
但这里有个容易被说错的地方
很多资料(包括我最初的理解)会说「chunked prefill 把 从 32768 钳到 4096,这个张量就从 137 GB 掉到 2 GB」——这个说法不准确。
只对应第一个 chunk。分块 prefill 的关键性质是:每个 chunk 都要对完整前缀做注意力(Sarathi-Serve 的做法是把一条 prefill 请求切成近似等长的块)。所以第 块的分数张量形状是:
只有 query 维被钳制到 ,key 维仍然是全前缀 。 于是:
| 块 | 分数张量形状 | FP16 大小 |
|---|---|---|
| 第 1 块 | 2.15 GB | |
| 第 4 块 | 8.6 GB | |
| 末块 | 17.2 GB |
所以准确的说法是:不开分块时峰值是 137 GB,开分块后压到约 17.2 GB(末块)——降低约 8 倍,而不是 64 倍。
原因是分数张量是二维的:query 维随 缩小,key 维不缩。只有那些真正只随「单步 token 数」增长的张量(Q/K/V 投影、FFN 中间态)才享受完整的 缩减。
补充:上面讨论的是「分数矩阵被完整物化」的情形。若走了 FlashAttention 类融合路径,这张矩阵根本不会落到 HBM,此时峰值由 的线性张量决定,chunked prefill 对它们的缩减是完整的 。这也说明:分块 prefill 与 FlashAttention 是互补而非替代关系——前者砍线性项,后者砍平方项。
一句话把两个问题缝起来
决定了每个 token 占多大空间(向量宽度), 决定了多少个 token 同时在场(并发宽度),而中间张量「用完即释放」的生命周期决定了整个显存曲线呈锯齿状而不是持续抬升。
Chunked prefill 砍的是锯齿的高度,不改变锯齿的形状。
常见误区速查
| 误区 | 正确理解 |
|---|---|
| 「d 就是神经元数量」 | 是每个 token 的特征向量宽度;FFN 中间维度才更像神经元数 |
| 「K/V 投影和 Q 一样宽」 | GQA 下 K/V 宽度是 num_key_value_heads × head_dim,通常远小于 |
| 「中间激活会一直占着显存到请求结束」 | 单算子执行完、引用消失即归还分配器池子,显存曲线是锯齿 |
「empty_cache() 能腾出更多可用显存」 |
它只归还分配器缓存,不增加 PyTorch 可用显存 |
「nvidia-smi 显示的就是张量占用」 |
那是分配器 reserved 的量,比真实张量占用 memory_allocated() 高 |
| 「FFN 中间维度就是 4d」 | 是常见经验值但不普适——Llama-3-70B 是 28672(≈3.5d),8B 是 14336(3.5d) |