为什么一条 32k 请求能瞬间打爆显存:中间激活张量、常驻水位与 Chunked Prefill
推理服务最常见的崩溃形态是这样的:系统平稳运行了很久,突然因为一条长文本请求 CUDA OOM,整个实例挂掉。
直觉上会去怪权重太大或 KV Cache 爆了。但权重是启动时就固定的,KV Cache 有 PagedAttention 分页管理、增长是缓坡——它们都不解释「瞬间」这两个字。
真正的元凶是第三类显存:中间激活张量。
一、显存的三类「性格」
把推理时的 GPU 显存按行为特征分成三类,很多 OOM 问题会立刻变得清楚:
| 类型 | 内容 | 增长方式 | 管理手段 |
|---|---|---|---|
| 常驻水位 | 模型权重 | 启动即固定,不随负载变 | 量化、张量并行 |
| 线性累积 | KV Cache | 随 token 数 缓坡上涨 | PagedAttention 分页、前缀缓存、KV 量化 |
| 瞬时峰值 | 中间激活张量 | 单步内 甚至 尖峰 | Chunked Prefill、FlashAttention |
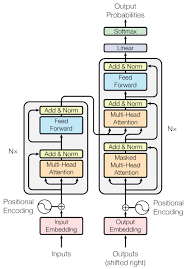
中间激活张量指的是前向计算过程中、每层算子之间临时产生并立即消费的那部分张量。它们既不是常驻显存的权重,也不是需要长期保留的 KV Cache,而是「算完一层就丢、算下一层再生成」的瞬时工作区。
这个三分法不是我的发明——vLLM 官方 mem_utils 文档就是这么拆的:显存 = 模型权重 + 为 peak activation tensors 预留的余量 + 非 torch 组件,并用 non_kv_cache_memory = total_consumed + transient_peak_headroom 这个式子明确把激活定义为瞬态峰值余量而非常驻占用。PyTorch 侧对应的度量是 allocated_bytes.all.peak。
所以判断一道 OOM 题是不是激活值打爆,核心就是看这三类显存的分工:权重和 KV Cache 决定「常驻水位」,中间激活决定「瞬时峰值」。
二、Prefill 每层到底产生哪些中间张量
以一条长度为 的 prompt(batch=1)过一遍标准 Transformer 的一个 block 为例:
| 阶段 | 张量 | 典型形状 | 随 的增长 | 生命周期 |
|---|---|---|---|---|
| 输入 | hidden states | 线性 | 进入本层即被消费 | |
| Attention | Q / K / V 投影 | 各一份 | 线性 | Q 算完注意力即可释放;K/V 写入 KV Cache 后释放 |
| Attention | 注意力分数 | 平方 | softmax 前后都是峰值大户 | |
| Attention | 线性 | 写回残差后释放 | ||
| FFN | 上投影中间态 | , | 线性 ,但系数大 | 激活函数后即消费 |
| LM Head | logits | 线性 , | 算完 logprob 即释放 |
其中两个形状最「胖」:
① 注意力分数矩阵 是唯一的平方项。 PyTorch 原生实现里 Q @ K.T 会把完整的 分数矩阵物化到 HBM。FlashAttention 论文对此的原话是「避免把 attention matrix 读写到 HBM」,做法是分块(tiling)、增量地做 softmax 归约,从而不需要访问完整输入(论文 Fig.1 图注:uses tiling to prevent materialization of the large N×N attention matrix)。
顺带澄清一个术语:论文本身不使用 “online softmax” 这个词,它引用的是 Milakov & Gimelshein 的 Online normalizer calculation for softmax(2018)。说「分块增量 softmax」或「tiling + 在线归一化」更准确。
但要注意:即便用了 FlashAttention,每层流过的 Q/K/V、FFN 中间态依然是 的线性大张量, 越大单层瞬时峰值越高。FlashAttention 消掉的是平方项,不是线性项。
② FFN 中间态是常被低估的一项。 它的放大系数是 。以 Llama-3-8B 为例,、,FFN 中间张量是输入 hidden states 的 3.5 倍大。MsT(Mini-Sequence Transformer,NeurIPS 2024)论文直接指出这类中间变量「can be nearly ten times larger than the input variables」,并认为它严重限制了序列长度与 batch 的扩展。
三、为什么「32k Prompt + 无 Chunked Prefill」会瞬时打爆
三个机制叠加:
1. 整条 prompt 必须单步过完前向。 关闭 chunked prefill 时,32k tokens 一次性进入 forward,每一层的 Q/K/V、FFN 中间态都按 分配。vLLM 文档对这个前提说得很直白:
When chunked prefill is disabled,
max_num_batched_tokensmust be greater thanmax_model_len. In that case, ifmax_num_batched_tokens < max_model_len, vLLM may crash at server start-up.
(源码判据是 >=,文档措辞 “greater than” 略不精确,以代码为准。)
2. 中间张量与 KV Cache 的增长模式根本不同。 KV Cache 是 的持久占用——持续累积,但可被 PagedAttention 分页管理,是缓坡;而中间激活是瞬时峰值——即使最终平均占用不高,某一层的 attention score 与 FFN 中间态同时在场时会形成一个尖峰,直接把剩余显存清零。
3. 与并发的乘法效应。 生产里这条 32k 长请求不是孤立运行的,它和若干 decode 请求共占显存。decode 请求贡献的是稳态 KV Cache,长 prefill 贡献的是瞬时激活尖峰,两者叠加时最容易触顶。
量级感受(Llama-3-70B,S=32768,FP16)
先说 KV Cache 作为对照。Llama-3.1-70B 每 token 的 KV Cache:
于是:32k 上下文 ≈ 10.74 GB,128k 上下文 ≈ 42.95 GB。
⚠️ 一处流传的错误:网上常见「0.33 MB/token,32k 约 43GB」的说法——这两个数字自相矛盾。按 0.33 MB/token 算,32k 是 10.74 GB;43 GB 实际对应的是 128K 上下文。
再看中间激活(Llama-3-70B:、、64 个注意力头、8 个 KV 头):
| 项 | 算式 | 量级 |
|---|---|---|
| 每层 Q/K/V 投影输出 | ≈ 0.67 GB | |
| 每层 FFN 中间态(SwiGLU gate+up 两份) | ≈ 3.76 GB | |
| 每层 attention score(未走融合路径时) | ≈ 137 GB |
⚠️ 两处常见算错:
- GQA 下 K/V 的宽度不是 。70B 有 64 个 Q 头但只有 8 个 KV 头,所以 K/V 各是 维。按 算会把 QKV 高估 2.4 倍(1.6 GB vs 真实 0.67 GB)。
intermediate_size=14336是 8B 的,不是 70B 的。70B 是 28672(自 Llama-2 起一直如此,并无「11k→14k」的变化——那个提升只发生在 8B 上)。用错会把 FFN 中间态算成 0.94 GB,实际是 1.88 GB/份。
第三项就是「一张 80GB 卡瞬间就没了」的来源——平方项一旦被物化,任何单卡都装不下。这也是为什么现代推理引擎默认都走 FlashAttention 类融合路径。
即使平方项被消掉,前两项加起来每层也要 ~4.4 GB 的瞬时工作区,再叠加并发请求的 KV Cache,160GB 总池在边界上很容易被打穿。
四、Chunked Prefill 如何把峰值压下来
Chunked prefill 的本质是把「单步过完整条 」改为「单步只过长度为 的一个块」,其中 max_num_batched_tokens。这样每层流过的张量形状从 变成 ,激活峰值被硬性限制在 而非 。
1 | 激活峰值 = f(单步处理的 token 数) |
除了防 OOM,chunked prefill 还顺带解决了另一个生产痛点:prefill 抢占 decode 造成的 ITL 尖刺。把长 prefill 拆成多个小步,decode 请求就有机会插进调度,不会被一次长 prefill 卡住几秒。
vLLM V1 默认开启这个特性(官方原文:In V1, chunked prefill is enabled by default whenever possible;源码 enable_chunked_prefill: bool = True)。对比 V0:v0.5.0 时默认是 False,v0.7.3 改为 Optional[bool] = None 但多数情况仍落到 False——这是 V0/V1 的一个行为分界,看老资料时容易踩。
代价是 prefill 被拉成多个 step,换来的是不 OOM 且 decode 不被粗暴抢占。
五、图解
按「显存分工条 + 左右对照面板」把整个机制串一遍:
1 | ┌─ 显存分工条 ────────────────────────────────────────────┐ |
六、一句话收束
权重和 KV Cache 决定「常驻水位」,中间激活张量决定「瞬时峰值」。
无 chunked prefill 的长 prompt 之所以会引发 OOM,是因为它让每层的 中间张量(以及非融合路径下的 attention score)同时一次性在场,峰值直接越过剩余水位线。
Chunked prefill 的本质,就是把峰值从 钳制到 。
生产检查清单
- 确认 chunked prefill 真的开着。V1 默认开启,但生产事故的形态通常是显式关掉它、或把
max_num_batched_tokens设到 ≥max_model_len(等价于没有分块)。 - 显存吃紧时优先调小
max_num_batched_tokens,而不是调小 batch——前者直接作用于激活峰值。 gpu_memory_utilization不要顶满。KV Cache 把剩余显存吃干净后,单次 prefill 的激活峰值仍可能顶破余量。- 长上下文模型要显式设
--max-model-len(不指定时会从模型 config 推导,对 1M 上下文的新模型等于默认放行极端长度)。 - 确认走了 FlashAttention 类融合路径——平方项一旦物化,任何单卡都装不下。
- 算显存时别踩 GQA 和模型参数的坑:K/V 宽度是
num_key_value_heads × head_dim而非hidden_size;intermediate_size要按对应模型规模取,不同规模差别很大。
参考资料
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135)
- MsT: Mini-Sequence Transformer(NeurIPS 2024,arXiv:2407.15892)
- vLLM Optimization and Tuning
- vLLM
mem_utils文档 - Meta Llama 3 论文(Table 3:各规模模型配置)
- Milakov & Gimelshein, Online normalizer calculation for softmax (2018)