AI Infra课程学习
AI Infra课程学习
AI Infra 工程师面经(305 题版,思维导图)
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 Roger-Lv's space!
相关推荐
2024-09-20
AI资源调度
AI资源调度 100道k8s面试题:https://zhuanlan.zhihu.com/p/721588398 [云原生 AI 的资源调度和 AI 工作流引擎设计分享_paddleflow-CSDN博客](https://blog.csdn.net/lihui49/article/details/129260286?ops_request_misc={"request_id"%3A"81C8FAB8-41BA-4FDC-A5E5-B7EF5F69A9D0"%2C"scm"%3A"20140713.130102334.."}&request_id=81C8FAB8-41BA-4FDC-A5E5-B7EF5F69A9D0&biz_id=0&utm_medium=distribute.pc_search_result.none-task-blog-2~all~sobaiduend~default-3-129260286-null-null.142^v100^pc_search_re...
2024-09-24
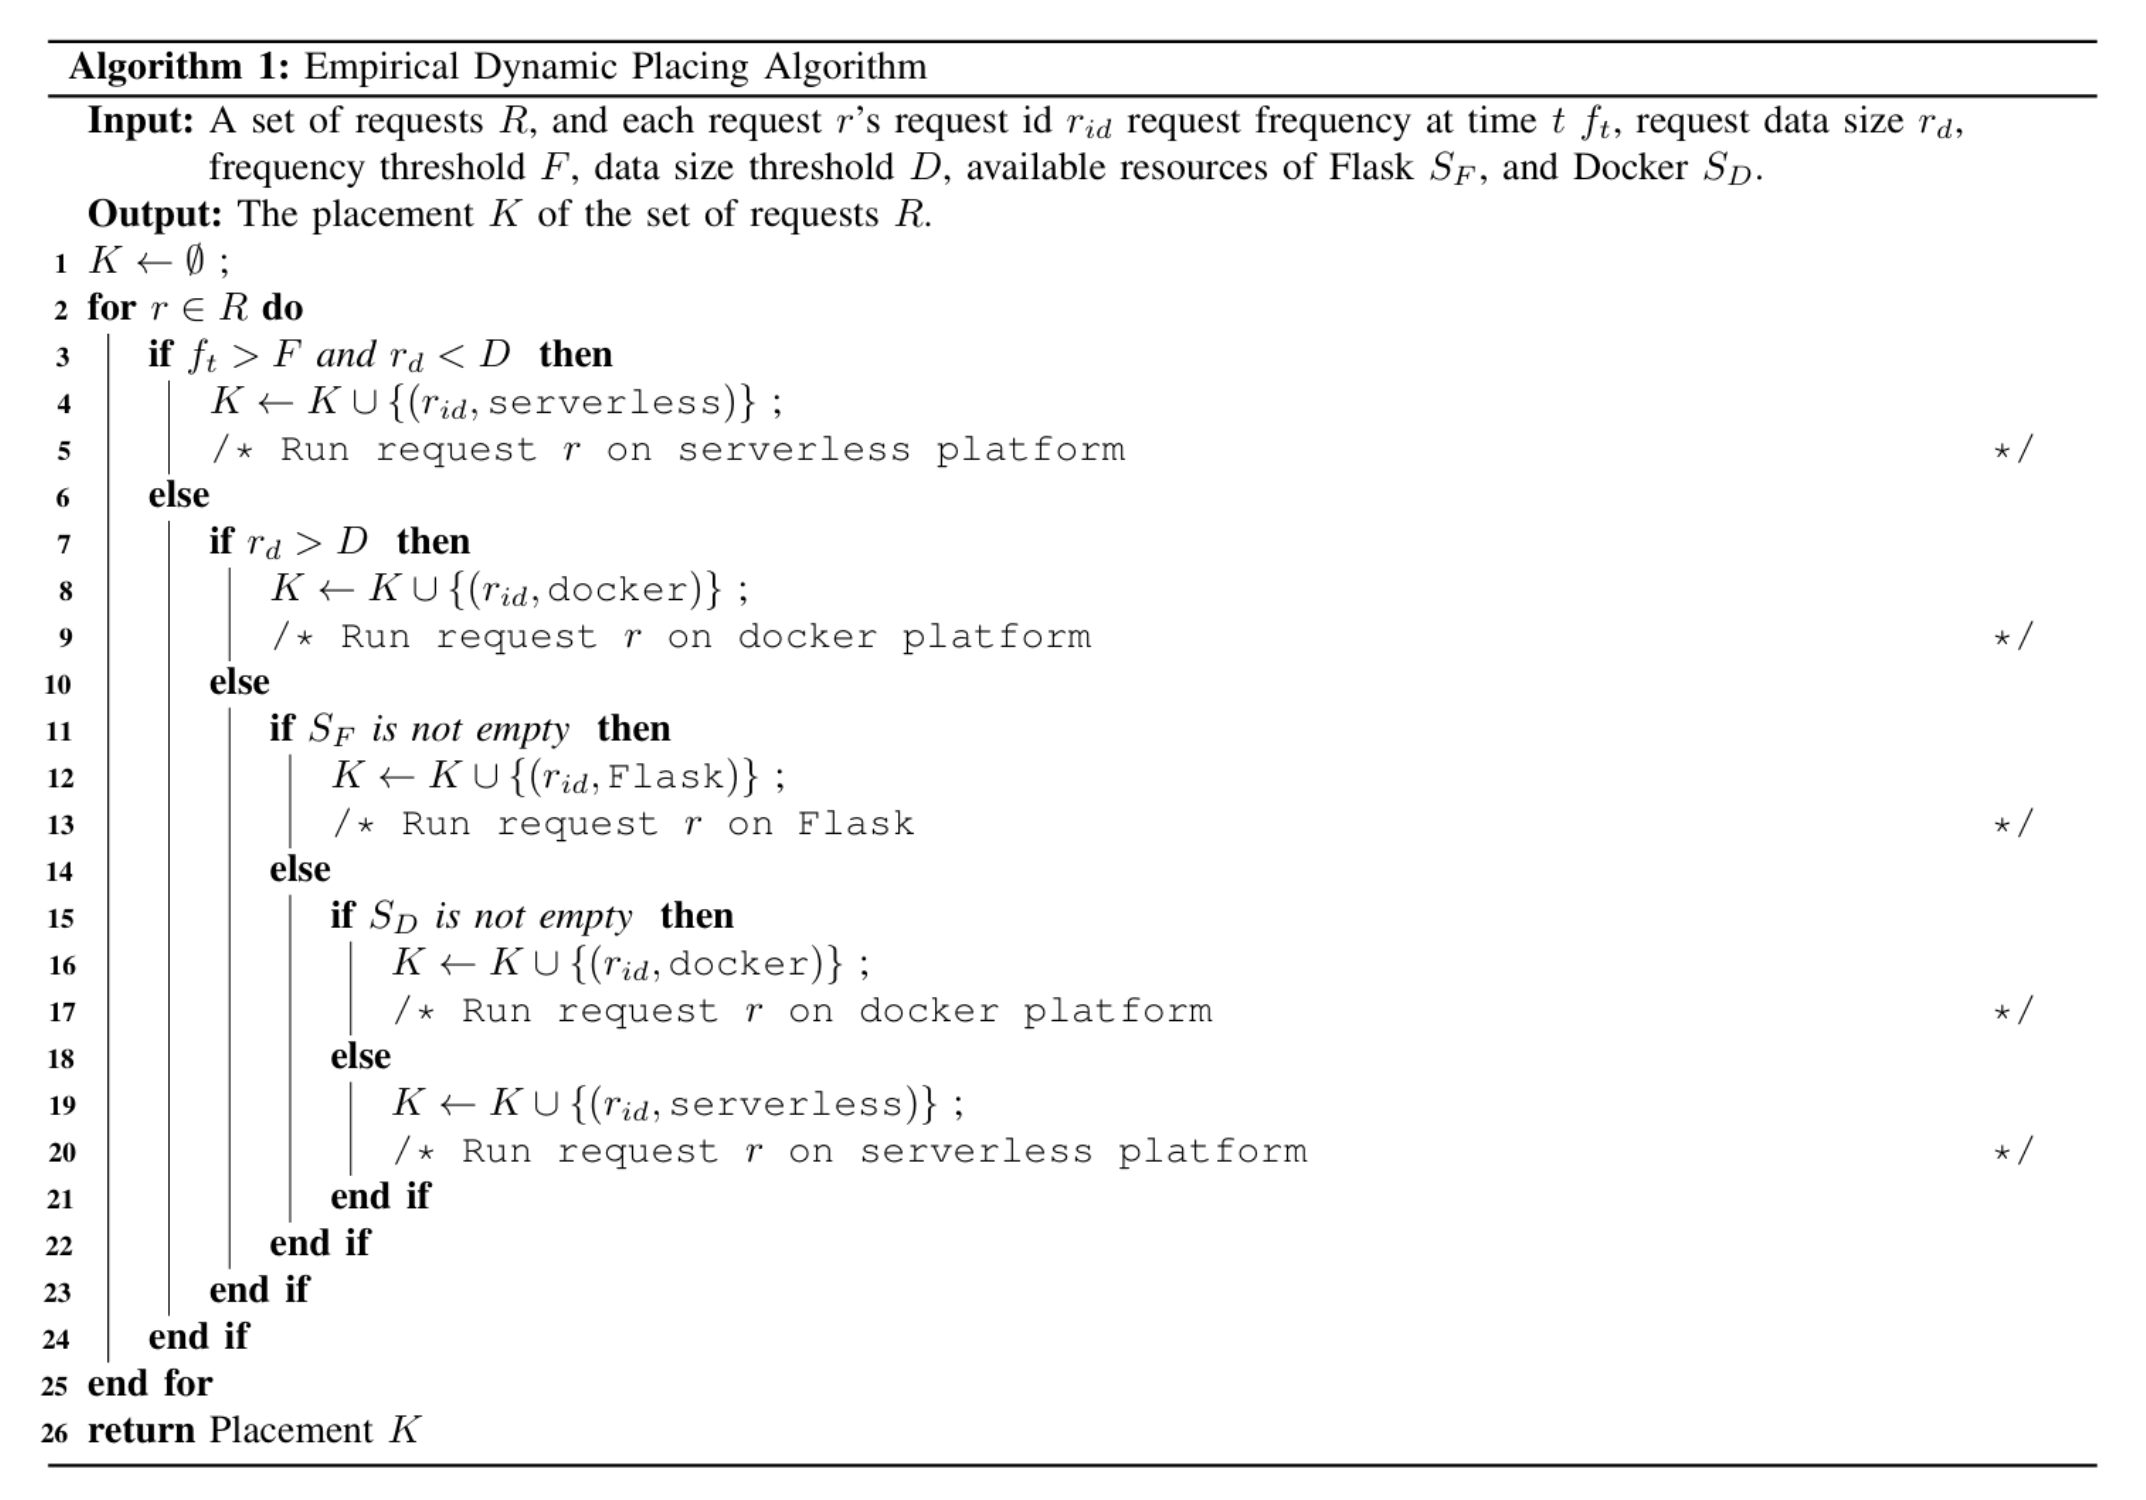
一种基于经验的动态资源调度:StraightLine:An End-to-End Resource-Aware Scheduler for Machine Learning Application Requests
StraightLine: An End-to-End Resource-Aware Scheduler for Machine Learning Application Requests 摘要: 提出了一个端到端的资源感知调度器,用于在混合基础设施中调度机器学习应用请求的最优资源。 关键词: 机器学习部署、异构资源、资源放置、容器化、无服务器计算。 主要内容: ML应用的生命周期包括模型开发和模型部署两个阶段。 传统ML系统通常只关注生命周期中的一个特定阶段或阶段。 StraightLine通过一个基于经验的动态放置算法,根据请求的独特特征(如请求频率、输入数据大小和数据分布)智能地放置请求。 包括三个层次:模型开发抽象、多种实现部署、实时资源调度。 模型容器化: 使用NVIDIA-Docker实现模型开发的容器化。 为模型训练构建了强大的NVIDIA-Docker,为模型验证构建了轻量级的NVIDIA-Docker。 深度学习docker环境配置之nvidia-docker安装使用_nvidia docker-CSDN博客 容器定制: 根据不同的压缩ML模...
2024-10-01
CUDA容器化&Container runtime相关技术梳理
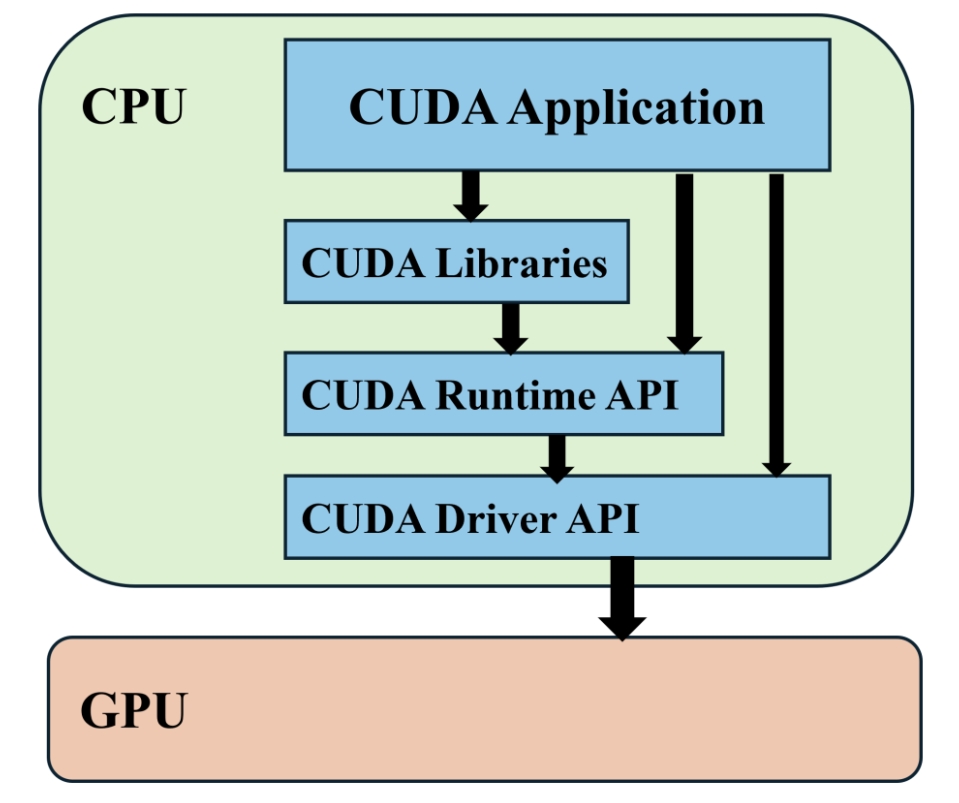
CUDA容器化&Container runtime相关技术梳理 整体结构 CUDA API体系 CUDA Driver API:GPU 设备的抽象层,通过一系列 API 直接操作 GPU 设备,性能好,但编程难度高(需要显式进行device初始化以及context管理等); CUDA Runtime API: 对 CUDA Driver API 进行一定封装,简化编程过程,降低开发难度; CUDA Libraries: 更高层的封装,包含一些成熟的高效函数库。 因此要实现 NVIDIA 容器化,也就是要让应用程序可以在容器内调用 CUDA API 来操作 GPU,一般来讲,就要使容器内应用程序内可调用 CUDA Runtime API 和 CUDA Libraries,容器内可使用 CUDA Driver 相关库。 NVIDIA CONTAINER TOOLKIT 具体结构 GPU 容器底层实现 GPU 容器相关概念 一些背景知识 什么是运行时?什么是高级运行时(high-level runtime)和低级运行时(low-level runtime): 参考:ht...
2025-11-10
NCCL通信原语
NCCL通信原语 参考: https://blog.csdn.net/2401_84208172/article/details/142610913?fromshare=blogdetail&sharetype=blogdetail&sharerId=142610913&sharerefer=PC&sharesource=a1150568956&sharefrom=from_link 1. Broadcast 其实就是把自己卡上面的东西让所有卡都知道 2. Scatter 其实就是把自己的东西分成多块,按照顺序向其他GPU发送data block 3. Reduce 就是把所有卡的部分在自己卡上面作一个sum。注意这里只有自己的卡作sum 4. Gather 其实对应于Scatter,是把分布在其他卡上的data block在自己卡上面拼起来。注意,这里也是只有自己这一张卡 5. AllReduce 每张卡都对所有卡作一个sum=reduce scatter+all gather, 通信成本也等于这俩加起来 官方说法:将每个节点的数据规约并...
2026-04-20
RDMA技术手册:面向AI场景的深度解析
RDMA技术手册:面向AI场景的深度解析 目录 概述 RDMA原理与架构 2.1 RDMA基本原理 2.2 RDMA网络类型与协议 2.3 RDMA编程模型与Verbs接口 2.4 GPUDirect RDMA技术 RDMA在AI场景的应用实践 3.1 RDMA在分布式训练中的应用 3.2 RDMA在推理服务中的应用 3.3 RDMA在存储与数据IO中的应用 3.4 RDMA在Kubernetes中的集成与实践性能优化与最佳实践 4.1 RDMA性能优化策略 4.2 性能测试与基准工具 4.3 典型问题与调优案例总结与展望 第1章 概述 背景与需求: 随着人工智能(AI)模型规模的爆炸式增长,训练和推理过程对网络通信提出了前所未有的高要求。传统基于TCP/IP的网络通信在延迟和带宽上已难以满足大规模分布式训练的需求。远程直接内存访问(Remote Direct Memory Access,RDMA)技术应运而生,它通过绕过操作系统内核,实现网络接口直接访问应用内存,从而极大降低了通信延迟、提高了吞吐量。在现代AI数据中心中,RDMA已成为加速分布式训练和大规模推理的关键网络技术。...
2026-05-06
AI Agent 的""安全游乐场":深入理解 Agent 场景下的沙箱技术
AI Agent 的“安全游乐场”:深入理解 Agent 场景下的沙箱技术 随着大语言模型驱动的 AI Agent 不再只是“动嘴”,而是能真实“动手”——运行代码、操控浏览器、调用系统命令——我们面临一个根本矛盾:如何让一个本质上不可预测的模型,在真实环境中安全地执行有副作用的操作? 答案就是沙箱(Sandbox)。它不是一个新鲜词汇,但在 Agent 时代获得了全新的内涵:沙箱不再仅仅是安全防线,更是赋予 Agent “自由探索、安全失败”能力的基石。本文将从必要性、具体形态、关键能力以及实际产品四个维度,为你拆解 Agent 场景下的沙箱技术。 一、为什么 Agent 比任何软件都更需要沙箱? 传统沙箱主要用于防止恶意软件越权,而 Agent 沙箱需要对抗的是一种更微妙的风险:模型输出的不确定性与工具的真实副作用之间的矛盾。 代码的“黑盒性” LLM 生成的代码完全不可预测——可能有逻辑错误、死循环,甚至包含 rm -rf / 这样的毁灭性指令。直接在主系统执行等于把钥匙交给了未知的“创作”。沙箱提供了一次性的、即使毁灭也不心疼的环境。 工具调用的真实副作用 当 ...
评论