为本科生设计一门大模型训练 Infra 课:16 周结构、大作业与开课清单
一句话结论:这门课不教学生训大模型,教学生在大模型训练系统里做工程判断——用一个 4—8 卡的小集群,完整走一遍万卡规模下的工程决策链,并且每一步都要留下可复核的证据。
最近受老师邀请,给北大本科生排一门面向大模型 Infra 的课,方向偏训练。从零设计到成稿改了几轮,中间被问得最多的是「32 学时塞得下吗」「算力从哪来」这两个问题。这篇文章把整套设计摊开讲,包括 16 周结构、大作业形态、以及几个我认为值得复用的具体做法,希望能给准备开同类课的老师省点事。
一、定位:本科阶段教不了「训大模型」,但教得了「做工程判断」
第一个要回答的问题是:本科生不可能真的训一个千亿模型,那这门课到底教什么?
我的答案是——教决策链,不教规模。一次大规模训练里真正难的从来不是「按下启动键」,而是一连串判断:
- 这个模型在这几张卡上,显存够不够?不够的话该切什么?
- 切完之后通信代价是多少?瓶颈在计算、通信还是显存?
- 换个框架、换个并行度,结论会不会变?
- 训练挂了,怎么知道是数据、通信、存储还是代码的问题?
这些判断的形状在小集群和万卡集群上是同一套,只是量级不同。所以课程把「规模」当作可控变量:给学生 4—8 卡,让他们把决策链完整走一遍。
由此定了三条原则:
- 不改进模型与算法,只做系统层的工程决策。 模型、语料、训练骨架都由教师提供,学生只动并行策略、框架选择、通信配置、数据管线与容错路径。这样组间对比才干净——否则算力和数据差异会污染所有结论。
- 每条结论必须有可复核的证据。 不接受「感觉快了很多」,只接受「MFU 从 0.31 提到 0.44,提升来自把梯度桶从 25MB 调到 100MB,因为通信占比从 18% 降到 9%」。
- 允许用 AI 辅助写代码,但必须能解释并验证。 评分看的是工程判断质量,不是代码行数。
课程最终落在 2 学分 / 32 学时 / 16 周,每组 1 个 4—8 卡 GPU 节点,真实多卡训练,不做仿真。
二、16 周结构
课程分两个阶段,以同一个训练任务连续推进。
| 阶段 | 周次 | 学时 | 主线 |
|---|---|---|---|
| 一、并行训练与显存优化 | 第 1—7 周 | 14 | 显存占用估算 → 单卡性能 → 数据并行(DDP / ZeRO)→ 张量并行(Megatron)→ 中期交付 |
| 二、规模化训练与集群底座 | 第 8—16 周 | 18 | 流水线 / 专家并行 → MoE 实验缓冲 → 框架与选型对照 → 通信 → 调度容错 → 存储数据 → 稳定性 → 推理对照 → 最终交付 |
具体的 16 周安排:
| 周次 | 授课内容 | 实践内容 |
|---|---|---|
| 1 | 课程介绍与大模型训练系统全景:从模型结构到计算图到 GPU;显存占用估算与混合精度 | 单人:手算并实测一个 1B 模型的训练显存占用估算,与推算对照 |
| 2 | 单卡性能剖析与算子优化:Roofline 模型、memory-bound vs compute-bound、Nsight、算子融合与 CUDA Graph | 单人:用 Nsight 定位一个 memory-bound 算子并优化 |
| 3 | 数据并行与梯度同步:all-reduce 数学、ring/tree 算法、梯度桶、通信计算 overlap;DDP 与 DeepSpeed ZeRO-1/2 的框架实现 | 单人:跑通 DDP 测通信占比,对比 ZeRO-2 前后显存 |
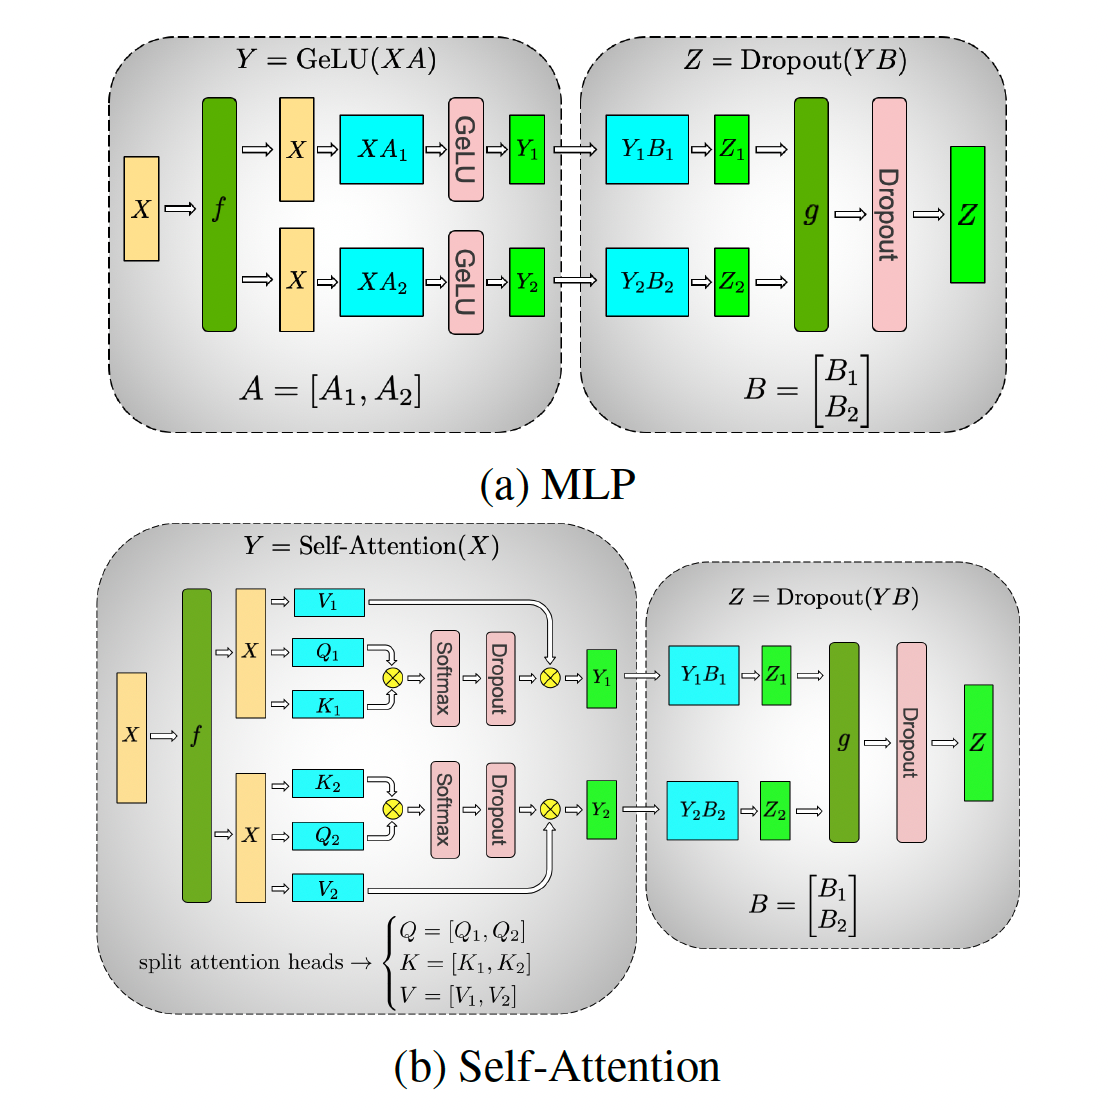
| 4 | 张量并行 TP 与序列并行 SP:列切 / 行切、通信量推导;Megatron 的 ColumnParallelLinear / RowParallelLinear 与藏在 autograd 里的通信 |
单人:推导 TP 通信量并跑通 TP=2/4 |
| 5 | (国庆假期) | 自主学习:远程完成一次 all-reduce 带宽实测 |
| 6 | 流水线并行 PP 与上下文并行 CP:micro-batch 流水、气泡占比 、1F1B 与 Interleaved 1F1B、ring attention | 团队:PP 气泡测量与 schedule 对比 |
| 7 | 团队项目中期汇报:并行策略诊断 | 单人:独立负责一个 CI workflow 文件;团队:并行策略诊断报告 |
| 8 | 专家并行 EP 与 MoE 训练:路由机制、容量因子、专家负载不均衡、All-to-All 通信 | 团队:MoE 层通信占比与负载均衡分析 |
| 9 | MoE 通信与负载均衡实验(模型并行之后的专设消化窗口) | 团队:完成一次路由 / 容量因子调优,给出前后对比与归因 |
| 10 | 训练框架与并行策略选型:FSDP / ZeRO 全分片、张量内 vs 张量间分片、优化器零通信、FSDP2 与 DTensor;三套框架横向对照与选型判据 | 单人:Tiny-FSDP 精读;团队:FSDP2 与 Megatron-LM 配置面 / 显存 / 吞吐对比 |
| 11 | 通信底座:NCCL 原语与算法选择(Ring / HD,NCCL / ACCL / HCCL 差异)、RDMA / RoCE / InfiniBand、拓扑感知 | 团队:网络拓扑对 all-reduce 带宽影响的实测 |
| 12 | 集群调度与容错训练:gang scheduling、拓扑感知放置、checkpoint 与断点续训、straggler 与 hang 检测 | 团队:故障注入与断点续训演练 |
| 13 | 存储与数据管线:并行文件系统与元数据缓存、checkpoint 写放大与异步落盘、数据清洗 / 去重 / 分词 / 打包 / 分片 | 团队:数据管线吞吐测试与 checkpoint 写性能 |
| 14 | 训练稳定性与可观测性:loss spike 归因、Timer 埋点、指标采集与日志、异常检测 | 团队:一次训练异常诊断报告 |
| 15 | 推理侧对照与弹性治理:vLLM / SGLang、PagedAttention、Continuous Batching、PD 分离;混部、GPU 超卖谱系 | 团队:训练与推理 Infra 的异同分析 |
| 16 | 团队项目最终汇报 | 团队:成果提交、跨组复现验收、维护与交接 |
学时分配是 讲授 24 + 实验实训 8 = 32:
| 教学模块 | 讲授 | 实验实训 | 合计 |
|---|---|---|---|
| 1. 训练系统全景与 GPU 基础 | 2 | 0 | 2 |
| 2. 单卡性能剖析与算子优化 | 2 | 0 | 2 |
| 3. 数据并行与梯度同步 | 2 | 0 | 2 |
| 4. 模型并行:TP / SP / PP / CP / EP | 6 | 2 | 8 |
| 5. 训练框架与并行策略选型 | 2 | 0 | 2 |
| 6. 通信底座 | 2 | 0 | 2 |
| 7. 集群调度与容错训练 | 2 | 0 | 2 |
| 8. 存储与数据管线 | 2 | 0 | 2 |
| 9. 训练稳定性与可观测性 | 2 | 0 | 2 |
| 10. 推理侧对照与弹性治理 | 2 | 0 | 2 |
| 11. 实验实训与汇报 | 0 | 6 | 6 |
| 合计 | 24 | 8 | 32 |
四次实验实训落在第 5、7、9、16 周。
三、几个我认为值得复用的设计
3.1 显存占用估算:先推算,后实测
这是全课的第一个动作,也是后面所有决策的基础。
混合精度 + Adam 下,每个参数的显存开销是 16 bytes:fp16 参数 2 + fp16 梯度 2 + fp32 master weight 4 + Adam 一阶矩 4 + 二阶矩 4。1B 模型代入就是 16 GB,还没算激活。
| 项 | 量级 | 性质 |
|---|---|---|
| 参数 + 梯度 + 优化器状态 | 16P bytes | 刚性,与 batch、序列长度无关 |
| 激活 | 随 batch × seq × layers 线性增长 | 最大变量 |
| 通信缓冲 | 梯度桶、all-gather 缓冲 | 随并行策略变 |
| 临时工作区 | cuBLAS / 融合算子 workspace | 难精确预估 |
| 固定开销 | CUDA context、cuDNN | 约 1—2 GB,不可压缩 |
为什么强调「先推算、后实测」而不是直接给公式:两者对不上时,差额本身就是信息——它说明学生对某个环节的理解有误(漏了 workspace、没算碎片、以为优化器状态是 bf16、忽略了通信桶)。只给公式,学生不会去对账;要求提交「推算 vs 实测」对照表,就会逼出「差在哪」这个问题。
而且这份估算直接决定后面怎么切——这是全课的主线:
| 手段 | 省什么 | 不省什么 |
|---|---|---|
| TP | 权重、优化器状态(层内切) | 激活 |
| PP | 权重(按层切,更彻底) | 激活 |
| DP / ZeRO / FSDP | 优化器状态、梯度、参数 | 激活 |
| 激活重计算 / SP / CP | 激活 | 权重 |
四类正交可叠加,这才是 5D 并行成立的原因。学生算完账,才知道自己该动哪一项。
3.2 框架作暗线:讲哪种切分,就落到哪个框架的实现
这是我在设计后期才想清楚的一条。
如果只讲抽象机制(「TP 是列切和行切」),学生会觉得听懂了但不会跑;如果只讲框架配置(「把 tensor_model_parallel_size 设成 2」),学生不知道为什么。把两者绑在一起讲效果最好:
- 讲 TP 时讲 Megatron 的
ColumnParallelLinear(按输出维切、前向不通信、反向一次 all-reduce)与RowParallelLinear(按输入维切、前向 all-reduce、反向不通信)如何配对,把 MLP 的 压成「整个子块一前一后各一次 all-reduce」;讲通信如何被包成 autograd Function 而出现在正确的反向位置。 - 讲 DP 时讲 Megatron 的
param_and_grad_buffer如何把几十个碎片参数攒成一个大桶、register_grad_ready如何触发异步 all-reduce。 - 讲 PP 时讲
get_forward_backward_func如何在 1F1B 与 Interleaved 之间分派、batch_isend_irecv如何一次收发多个张量。 - 讲 FSDP 时讲 all-gather / reduce-scatter 如何挂在逐层前反向回调上。
第 10 周再收束成一次横向对照,把三套框架摆在一起:
| Megatron-LM / Megatron-Core | DeepSpeed(ZeRO) | FSDP / FSDP2 | |
|---|---|---|---|
| 切什么 | 层内切权重(TP)+ 按层切(PP)+ 序列/上下文/专家维 | 主要切数据并行维的状态 | 切数据并行维的参数与状态 |
| 分片粒度 | 层内权重切分,无「分片」概念 | 张量间(inter-tensor) | 张量内(intra-tensor,dim-0 均分) |
| 通信模式 | 每层 2 次 all-reduce;PP 走 P2P | broadcast / reduce | all-gather / reduce-scatter |
| 模型代码侵入 | 高,须按 GPTModel 规范重写 |
中 | 低,模型外 wrap |
| 规模 | 70B 以上、数千卡 | 7B—100B、需要 offload | 1B—34B、单节点到少量多机 |
| 生态 | 自有(ckpt 需转换 HF 格式) | HF / PyTorch 均可 | HuggingFace Accelerate、peft 原生 |
张量内 vs 张量间分片这个对照我认为最值得讲透:FSDP 是每个参数张量沿 dim-0 均分,负载天然均衡,代价是每次前反向都要聚合整个张量;ZeRO-3 是以整个张量为粒度分给 owner rank,小张量不必切,但可能出现某卡持有很多大张量而另一卡空闲。
还有一个反直觉的点:FSDP 的优化器阶段零通信——因为梯度已经在反向 reduce-scatter 到各卡,Adam 的一二阶矩天然就是 分片,各卡独立更新即可。以及 reduce-scatter 语义上等价于「先 all-reduce 再切片」但通信量减半。
选型判据按四类问题依次问:规模(单卡装得下就 DDP;500M—34B 用 FSDP;7B—100B 需要 offload 用 ZeRO-3;70B 以上数千卡才上 Megatron)、结构(是不是标准 dense Transformer)、生态(是否依赖 HF / 是否需要 torch.compile)、团队成本(代码侵入度、错误栈可读性)。
3.3 第 9 周:为模型并行专设的消化窗口
这是我改过一轮的地方,也是我目前最满意的一处结构设计。
原本的排法是第 6、8、9 周连讲 TP/SP、PP/CP、EP/MoE,第 10 周直接进框架选型。问题是连续三周高密度并行内容,学生没有消化窗口,容易进入「听懂了但不会跑」的状态。
改法是把模块 1「训练系统全景与 GPU 基础」从 4 学时压到 2 学时(GPU 执行模型与显存层次的细节前移到第 0 周阅读材料),腾出的 2 学时给第 9 周做专设的 MoE 实验周。
现在第 4、6、8 周讲切分,第 9 周动手把通信账目跑成学生自己的数据,第 10 周再进框架选型。学生带着实测数字去讨论「该选哪套框架」,效果比纯听讲好得多。
顺带把 MoE 那周的课堂焦点收窄了:ETP(专家张量并行)、EDP(专家数据并行)与 NVSHMEM 单边通信降为概念介绍 + 拓展阅读,课堂只聚焦「All-to-All 通信占比怎么测、测出来说明什么」。一周讲不完的内容就明确标为拓展,比硬塞进去更好。
3.4 跨组复现验收:15 项检查表
跨组验收最容易变成走过场——「看起来能跑」就打勾。所以把「能否启动、结果能否复现、交接是否清楚」拆成了 15 项可勾选的具体动作:
| # | 检查项 | 判定 |
|---|---|---|
| 1 | 仓库 README 含环境、依赖与启动命令 | 有 / 无 |
| 2 | 依赖可一键安装,无手工步骤 | 是 / 否 |
| 3 | 启动命令按文档原样执行即可跑通 | 是 / 否 |
| 4 | 随机种子与数据版本已固定并可复现 | 是 / 否 |
| 5 | 正确性验证脚本可独立运行并给出明确结论 | 是 / 否 |
| 6 | 性能基线与实测值差异在 ±10% 以内 | 是 / 否 |
| 7 | 并行配置写在配置文件中,非硬编码 | 是 / 否 |
| 8 | 换一种并行度后脚本仍能启动(不需改代码) | 是 / 否 |
| 9 | 断点续训可从 checkpoint 恢复并继续训练 | 是 / 否 |
| 10 | 恢复后的 loss 与中断前连续(无跳变) | 是 / 否 |
| 11 | 显存占用的推算与实测对照表可复核 | 是 / 否 |
| 12 | 已知限制与适用条件写明 | 有 / 无 |
| 13 | 可复用组件(工具 / 配置 / 评测脚本)已指出 | 有 / 无 |
| 14 | 启动失败时有明确的报错与排查提示 | 有 / 无 |
| 15 | 交接材料足以让非本组同学独立跑通 | 是 / 否 |
第 5—10 项为必过项,任一项不通过则该次验收记为未通过,开发组须在课外完成修复与回归,再由验收组复核。其余项只形成反馈意见,不影响通过与否。
第 7、8 两项是我特意加的:并行配置硬编码和换并行度就跑不起来是学生项目里最常见的两个坑,写进必过项等于强制他们把配置和代码解耦。
3.5 基准配置打 v1.0 tag 锁死
大作业最怕组间配置漂移——A 组改了 seq_len、B 组换了 tokenizer、C 组用了不同的随机种子,最后所有性能对比都失去意义。
做法是把模型配置、语料、tokenizer、seq_len 与随机种子以 v1.0 tag 锁死(1B dense 与 8 专家 MoE 两套),学期中途只通过 changelog 修订。各组只改并行策略、框架选择、通信配置、数据管线与容错路径。
3.6 先修自检清单 + 第 0 周 warm-up
这门课对大二学生其实不轻松:需要 PyTorch 训练循环、torch.distributed、读懂 autograd.Function、Linux/Git、SLURM 或 K8s、Nsight 命令行。这些不显式声明,前两周会直接卡住。
所以写了一份自检清单(明确说明「这不是筛选门槛」):
| 能力 | 自检项 |
|---|---|
| 编程 | 能用 PyTorch 写出完整训练循环(数据加载、前反向、优化器步进、保存与加载) |
| 分布式编程 | 能用 torch.distributed 写一个多进程 all-reduce demo,并解释 init_process_group / rank / world_size |
| 自动微分 | 能读懂一个自定义 torch.autograd.Function,说清 forward 与 backward 各自算什么 |
| 系统工具 | 熟悉 Linux / Shell、SSH、Git(含分支与冲突处理) |
| 调度系统 | 熟悉 SLURM 或 Kubernetes 任一:能提交作业、看日志、看资源占用 |
| 性能工具 | 能跑通 Nsight Systems 的命令行采集并打开报告 |
配套一个第 0 周 warm-up 仓库(开学前,不计学时),把三条工具链提前打通:torch.distributed 写 all-reduce demo 跑通 2 卡与 4 卡、对给定脚本做一次 nsys profile、在一个示例仓库上跑通一条 CI。
warm-up 不计分,但第 1 周课堂会现场抽查。关键是让学生带着能跑的环境进第 1 周,而不是把前两周耗在环境上。
3.7 算力 SLA 与降级预案
这条是被质疑后补的,我认为所有开同类课的老师都该准备。
先算清卡时账(而不是硬件采购价——高校开课用的是既有集群,不是为新课程买机器):
| 项 | 数值 |
|---|---|
| 组数 | 10 |
| 每组节点规格 | 4—8 卡 |
| 每周保底时段 | 2—4 小时 |
| 学期周数 | 16 |
| 学期总卡时 | 1,280—5,120 卡时(中位配置约 2,880) |
这个数量级对任何具备多节点 GPU 资源的计算中心都属于常规教学负载,但必须在开课前与集群管理方书面确认时段与配额。
再给明确的服务保障与降级路径:
- 保底卡时:每组每周不少于 2 小时,全学期不少于 32 小时
- 故障响应:节点故障 24 小时内响应,超过 48 小时未恢复则触发降级
- 降级路径:4 卡不可用 → 降为 2 卡跑通(并行度相应下调);节点不足 → 两组共用 8 卡节点分时段;集群整体不可用 → 改用预录轨迹、仿真接口与已录制的 Nsight 报告完成分析类实验
这里有个我觉得挺重要的教学点:2 卡跑通本身就是一次真实的容量约束决策——哪些结论在 2 卡上仍然成立、哪些必须标注为「未验证」,这正是学生该学会的判断。所以降级不等于降低要求:所有降级路径下,学生仍须完成正确性验证、显存估算对照与一次有依据的修改;只有性能对比类结论允许缩小规模,且必须在报告中说明实际配置。
四、被质疑最多的四个问题
4.1 「32 学时塞得下吗?」
塞不下,这是设计上真实的问题。 我最初的版本铺了 12 个主题,连续三周推流水线、专家并行和框架选型,中间没有消化窗口。参考其他高校的 LLM 系统课(比如 Stanford CS336 把分布式训练拆成多讲并配大作业),这个密度明显偏高。
处理方式就是 3.3 说的:压缩模块 1、腾出第 9 周做消化窗口、把讲不完的内容(ETP/EDP/NVSHMEM)明确降为拓展阅读。能砍就砍,不要指望学生课外补上。
4.2 「算力从哪来?」
这个问题的问法比答案重要。常见的一种论证是算节点采购价(比如一台 8×H100 节点二十多万美元),但这对高校开课是个错误的框——院系不会为一门课买机器。
真正该回答的是卡时消耗:1,280—5,120 卡时/学期,中位约 2,880。把它和集群的日常科研负载放在一起比较,结论很清楚。剩下的就是流程问题:开课前书面确认时段与配额。
4.3 「2 学分撑得起这个工作量吗?」
说实话,撑不太起。课内 2 学时 + 课外 4—6 小时/周 × 16 周 = 96—128 小时,已经接近 5 单元课程的强度。在现行绩点体系下,2 学分对学生的投入激励确实不足。
我的处理是:如果只能给 2 学分,该砍的是内容,不是考核。 尤其不要为了减负把「个人理解与变化任务检查」改成可选加分项——那一环恰恰是防止「一人干活全组得分」的机制,砍它会把问题放大。
4.4 「个人任务和团队交付是不是耦合了?」
这是被指出的一个真实漏洞。我原本把「配置 CI 门禁」列为第 7 周的单人任务,但它同时就是团队中期交付物——个人分和小组分在这一处耦合了,容易出现「一人干活全组得分」或反之的争议。
改法是把单人任务明确为「在团队 CI 仓库中独立负责某一个 workflow 文件」,并在中期报告中签名标注该文件,使个人贡献可核验。
五、给准备开同类课的老师:一份清单
如果让我重新开始,会按这个顺序准备:
- 先定「不教什么」——明确划定范围(比如不碰模型改进、不碰算法),比列要教什么更重要。
- 把基准配置做出来并锁版本——模型、语料、tokenizer、seq_len、随机种子打 v1.0 tag。没有这个,所有组间对比都是空谈。
- 三套框架的最小可运行配置各跑通一遍——Megatron-LM、DeepSpeed、FSDP2。学生不承担安装与适配负担,但教师必须先试跑。
- 写先修自检清单,配一个 warm-up 仓库——把
torch.distributed、Nsight CLI、GitHub Actions 三条工具链提前打通。 - 算卡时账,谈时段配额,写降级预案——不要用采购价论证,用卡时。
- 设计大作业时先想清楚「验收怎么验」——15 项检查表倒逼出来的项目要求,比先设计项目再想验收要干净得多。
- 给高密度模块后面留消化周——尤其是并行策略这种需要动手才能理解的模块。
- 把个人任务和团队交付的边界写清楚——具体到「哪个文件、谁负责、怎么核验」。
六、结语
设计这门课最大的收获,是想清楚了一件事:本科阶段的 Infra 课,价值不在于让学生接触到多大的规模,而在于让他们把一条完整的工程决策链走通、并且每步都有证据。
4 张卡和 4 万张卡,在「显存不够该切什么」这个问题上是同一个问题。区别只是 4 张卡上错了代价很小,4 万张卡上错了代价很大——而这恰恰是本科阶段最该让学生犯错的成本结构。
课程材料(16 周表、课程大纲、验收检查表)还在打磨,等正式开课后会把实践反馈补上来。如果这篇文章对你有用,或者你也在设计类似的课,欢迎交流。
相关阅读