从 O(n²) 到 O(n):线性注意力、稀疏注意力与混合注意力的技术演进
从 O(n²) 到 O(n):线性注意力、稀疏注意力与混合注意力的技术演进
一句话结论:三种机制都是对标准 Transformer 中 复杂度的 Softmax 全注意力瓶颈的改进方案——线性注意力通过核函数分解把复杂度降到 ;稀疏注意力通过结构化掩码只计算部分 token 对的交互,复杂度降至 或 ;混合注意力则将不同注意力范式(或 Mamba/SSM)分层组合,在效率与精度之间取得平衡。
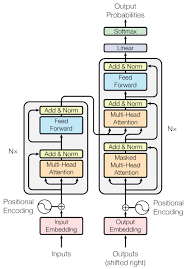
自 2017 年 Transformer 问世以来,注意力机制的核心公式几乎没有变过:每个 token 要与序列中所有其他 token 计算相似度,再加权聚合 value。这一设计赋予了模型强大的全局建模能力,但代价是计算量与序列长度的平方成正比。当上下文从 2K 扩展到 128K、再到 1M, 成为了绕不开的墙。过去五年,学术界与工业界从三个不同方向突破这堵墙,本文将逐一拆解其数学原理、典型实现与工程取舍。
一、问题的起点:标准注意力的 O(n²) 瓶颈
回顾标准缩放点积注意力的定义:
其中 , 为序列长度, 为头维度。计算 需要产生一个 的矩阵,时间复杂度为 ,显存占用同样随 增长。
根本障碍在于 softmax 函数: 无法分解为只含 的项与只含 的项的乘积,因此矩阵乘法的结合律无法被利用,必须先完整算出所有 个相似度分数,才能对每行做归一化。
此外,自回归推理时模型需维护随上下文线性增长的 KV Cache——在 128K 上下文下,仅缓存就可达数 GB,严重制约部署。
二、线性注意力:用核技巧重写 softmax
2.1 核心思想与数学推导
线性注意力的切入点是:既然 softmax 不可分解,就用一个可分解的核函数替代它。引入一个非负特征映射 (最经典的选择是 ,也有 、随机特征等),将注意力重写为:
这一改写的关键在于去掉了 softmax 的指数归一化后,矩阵乘法重新满足结合律:可以先计算 ,得到一个 的小矩阵,再用每个 query 去查询它。复杂度从 降至 ,当 时近似线性。
2.2 三条技术路线
(1)Linear Transformer(Katharopoulos et al., 2020):奠基之作,首次提出用 替代 softmax 的范式,并证明这样的 Transformer 可等价改写为 RNN,实现 4000 倍推理加速。
(2)Performer(FAVOR+):不放弃 softmax,而是用正交随机特征对 softmax 核做无偏估计——将 近似为有限维随机特征的内积 ,既保留了 softmax 的理论性质,又获得线性复杂度。
(3)Gated DeltaNet 一族:最新演进。把状态更新从简单的累加 改为带门控的 Delta Rule 修正:
其中 控制遗忘, 控制新信息的写入强度。这种"先减去旧值再写入新值"的增量更新,显著提升了记忆的精确性,已用于 Qwen3.8 等生产级模型。
2.3 优势与代价
| 优势 | 代价 |
|---|---|
| 长序列训练/推理速度大幅提升 | 核映射对 softmax 是近似而非等价 |
| 推理时只需固定大小状态矩阵(无 KV Cache) | 注意力分布熵更高、更"均匀" |
| 显存恒定,适合边缘部署 | 失去"点积越大权重越大"的单调性 |
| 适合 100K+ 超长上下文 | 精确检索、长程召回能力弱于稠密注意力 |
三、稀疏注意力:只算该算的 token 对
3.1 核心观察与掩码设计
稀疏注意力的出发点是一个经验观察:训练好的 Transformer 的注意力矩阵高度稀疏——绝大多数位置对的权重接近零,为这些"无用"位置付出的 开销可以省去。通过显式掩码限制每个 token 只关注一个子集,复杂度可降至 、 或 。
3.2 三大典型模式
以 BigBird 为例,其注意力掩码由三部分构成,复杂度为严格的 :
- 局部滑动窗口:每个 token 只看邻域内固定 个 token,利用语言的局部性;
- 全局 token:保留 个特殊位置(如 CLS、分隔符),既被所有人看到、也能看到所有人,捕捉长程依赖;
- 随机连接:每个 query 随机连接 个 key,增加图连通性。
BigBird 的理论贡献在于证明了这种稀疏结构仍是图灵完备的通用逼近器,即表达能力并未因稀疏化而损失。Longformer 去掉了随机连接,仅保留滑动窗口 + 全局 token,更简单实用。Sparse Transformer(OpenAI)则采用跨步模式,复杂度为 。
3.3 静态 vs. 动态稀疏
一个关键的工程区分:
- 静态(原生)稀疏:Longformer、BigBird 在训练阶段就固定掩码模式,需从头训练,无法即插即用;
- 动态(推理)稀疏:H2O、StreamingLLM、NSA 等在稠密模型上运行时动态裁剪 KV Cache 或选取关键 token。例如 DeepSeek 的 NSA 采用分层策略——先用 MLP 将 32 个 token 压缩为 1 个粗粒度块捕捉全局,再基于中间结果选取 top-16 关键块做精细计算,并做了硬件对齐优化以避免非连续内存访问抵消速度收益。
3.4 常见误区澄清
FlashAttention 不是稀疏注意力。FlashAttention 不改变注意力的数学定义,只通过分块计算和 kernel fusion 降低常数开销与显存占用,精度与稠密注意力完全等价,无法消除 本身。它解决的是"算得快",而稀疏注意力解决的是"算得少"。
四、混合注意力:分层组合、各司其职
4.1 两种含义
"混合注意力"在文献中有两层含义:
- 广义:同一模型中组合局部注意力与全局注意力、线性注意力与全注意力等不同注意力机制;
- 狭义(更主流):Mamba/SSM 层与 Transformer 注意力层的混合架构,即 Hyena、Jamba、Zamba、Hymba 等一系列模型所代表的方向。
4.2 为什么 Mamba 与 Attention 是互补的
混合架构的理论基础来自 Mamba 与 Attention 在序列建模上的互补性:
| 维度 | Mamba/SSM | 全注意力 |
|---|---|---|
| 复杂度 | 训练, 推理 | 训练, 推理 |
| 状态 | 固定大小隐状态 | 随上下文增长的 KV Cache |
| 擅长 | 过滤与压缩历史信息 | 精确检索与细粒度对齐 |
| 弱点 | 精确召回、上下文学习 | 长序列效率 |
频域分析进一步表明:Mamba 响应偏向低频(捕捉长期趋势),注意力全频均匀(捕捉短期细节),混合可同时捕获两者。
4.3 代表模型与融合范式
Jamba(AI21 Labs, 2024)——交错式混合:首个大规模部署的混合模型,总参 52B / 激活 12B,原生支持 256K 上下文,可在单张 80GB GPU 上运行。其架构以"Jamba block"为基本单元:每个 block 内含若干 Mamba 层 + 1 个注意力层,可配置 attention-to-Mamba 比例,部分 MLP 替换为 MoE 层。KV Cache 仅为纯 Transformer 的约 1/8。
Zamba2(Zyphra)——共享式混合:Mamba2 骨干交替共享少量注意力层,配合 LoRA 让共享层在不同深度产生特化。首 token 延迟降低约 50%,KV 内存减少约 6 倍。
Qwen3.8(阿里巴巴)——线性 + 全注意力混合:采用"3 层 Gated DeltaNet + 1 层全注意力"的 3:1 比例,在 64 层结构中 48 层为线性注意力、16 层为全注意力,原生 262K 上下文。线性层承担长上下文效率,全注意力层作为"高精度锚点"负责精确检索。
4.4 层间比例是最关键的设计超参
常见配置为 3:1、5:1、7:1(Mamba 或线性注意力 : 全注意力)。比例越高,长序列效率越好,但上下文学习能力越弱;反之亦然。理论分析表明混合架构的建模能力不低于任一单独架构,最坏情况下可退化为单一架构。
五、三种机制全景对比
| 维度 | 线性注意力 | 稀疏注意力 | 混合注意力 |
|---|---|---|---|
| 核心思路 | 用特征映射 替代/分解 softmax,改变计算顺序 | 只让每个 query 关注部分 key(窗口/全局/随机) | 不同注意力范式分层交错或并行组合 |
| 复杂度 | ,近似 | 、 或 | 取决于混合比例,通常介于 与 之间 |
| 是否改数学定义 | 是(近似 softmax) | 是(改交互拓扑) | 是(层间异构组合) |
| 是否保留精确检索 | 否(近似导致分布更均匀) | 部分保留(全局 token 可做精确匹配) | 是(全注意力层做精确锚点) |
| KV Cache | 无,固定状态矩阵 | 压缩为窗口+全局 token | 线性层无 cache + 注意力层少量 cache |
| 典型模型 | Linear Transformer、Performer、Gated DeltaNet、GLA | Longformer、BigBird、Sparse Transformer、NSA | Jamba、Zamba2、Qwen3.8、Hymba |
| 是否可即插即用 | 否,需重新训练 | 静态版否;动态版可 | 否,需重新训练 |
| 训练稳定性 | 门控版本较稳定 | 较好 | 设计复杂,超参敏感 |
flowchart LR
    A[标准Softmax注意力<br/>O n²] --> B[效率瓶颈<br/>长上下文受限]
    B --> C[线性注意力<br/>核分解至 O n]
    B --> D[稀疏注意力<br/>结构化掩码至 O n]
    B --> E[混合注意力<br/>分层组合取平衡]
    C --> F[Linear Transformer<br/>Performer<br/>Gated DeltaNet]
    D --> G[Longformer<br/>BigBird<br/>NSA]
    E --> H[Jamba<br/>Zamba2<br/>Qwen3.8]
六、工程选型指南
三种机制的适用场景存在清晰分界,但并非互斥:
(1)百万级超长上下文、推理吞吐与显存极度敏感——首选线性注意力(尤其 Gated DeltaNet 等带门控的现代变体)。典型如边缘部署、流式处理、基因序列建模。需接受精确召回上的精度损失,可通过混合少量全注意力层缓解。
(2)数万到数十万 token 的长文档、希望保留 softmax 的精确交互——首选稀疏注意力。原生结构化稀疏(Longformer/BigBird)适合从头训练场景;动态稀疏(NSA、H2O)适合在已有稠密模型上即插即用。
(3)训练通用大模型、在长上下文效率与精确检索/上下文学习间取平衡——首选混合架构。这是当前前沿模型的主流方向,Qwen3.8 的 3:1 配置、Jamba 的注意力锚点设计都印证了这一趋势。
实践中三条路线正在融合:Qwen3.8 同时使用线性注意力(Gated DeltaNet)作为"混合"的组成部分;NSA 的动态分层借鉴了"压缩 + 精选"的线性思想。工程上真正的取舍是"损失多少精度换多少效率"的连续谱,而非非此即彼的选择。
结语:从"一种注意力"到"一套注意力组合"
回顾这三种机制的演进逻辑,可以看到一条清晰的技术脉络:
- 2017-2019(瓶颈显现):标准 softmax 注意力统治 NLP,但 O(n²) 限制了长上下文应用;
- 2019-2020(结构稀疏化):Sparse Transformer、Longformer、BigBird 通过显式掩码砍掉无效交互,BigBird 证明了稀疏结构仍图灵完备;
- 2020-2021(数学线性化):Linear Transformer、Performer 用核技巧重写 softmax,复杂度降至 O(n);
- 2023-2024(状态空间复兴):Mamba/SSM 以线性复杂度 + 固定状态挑战注意力范式;
- 2024-至今(混合成为共识):Jamba、Qwen3.8 等证明"线性层提效 + 全注意力层保精度"的混合架构是当前最优解。
未来注意力机制的研究方向很可能不再是寻找"唯一的更高效注意力",而是如何智能地组合多种范式——动态决定在序列的哪些位置使用哪种注意力,让"效率-精度"的取舍从静态架构设计变为运行时自适应决策。
参考文献(按正文出现顺序):
- Katharopoulos et al., Fast Autoregressive Transformers with Linear Attention, 2020
- Choromanski et al., Rethinking Attention with Performers, 2020
- Zaheer et al., Big Bird: Transformers for Longer Sequences, 2020
- HuggingFace, Understanding BigBird’s Block Sparse Attention
- Yang et al., Gated Delta Networks: Improving Mamba2 with Delta Rule
- Lieber et al., Jamba: A Hybrid Transformer-Mamba Language Model, 2024
- Qwen3.8 技术报告