浅谈大规模集群的高性能网络容器化建设:从机器内通信到容器化 RDMA
浅谈大规模集群的高性能网络容器化建设:从机器内通信到容器化 RDMA
计算机硬件的通信方式大体分为两种类型:机器内通信和机器间通信。大模型训练把这两条路径都压到了极限——GPU 之间在机器内要全速交换分片权重,跨机器要跑 all-reduce 梯度洪流。这篇文章沿着这两条路径往下走:先看机器内 NVLink/GPUDirect 那套硬件互联,再看机器间 RDMA 的三种网络与无损组网,最后落到平台侧真正要回答的问题——如何把这些高性能网络以容器的方式交付给用户。
一、机器内通信技术
1.1 共享内存
狭义上的共享内存通信,指的是在 CPU 的内存上开辟一段空间,让不同进程都能访问到。具体形式可以是某种"句柄",让数据的存在可以借助此句柄跨进程引用这片内存。在容器里我们通常说的是 /dev/shm 这个目录,不同进程直接访问,做到 zero copy。
广义上的节点内 GPU 通信走共享内存,是指支持 GPU 与第三方 PCIe 设备(网卡、存储等)通过共享 pin 住的 host memory 实现共享内存访问,从而加速通信——这就是 GPUDirect Shared Memory 技术。
GPU Direct 技术实现单机内部 GPU 之间高速通信最大的挑战,是数据经过主机 CPU 的开销和内存拷贝的延迟。为了解决这个问题,NVIDIA 从 2010 年 6 月开始推广并持续演进 GPUDirect 技术系列,旨在优化 GPU 之间(P2P)或 GPU 与第三方设备(RDMA)之间的数据传输。
对比效果很直接:
- 没有 GPUDirect:GPU 需要把数据从显存复制到 GPU 驱动在系统内存中 pin 住的 Memory 1,再从 Memory 1 复制到 Memory 2,之后才能做进一步传输;
- 使用 GPUDirect Shared Memory:内存空间实现共享,减少一次数据复制,降低数据交换延迟。
2011 年,GPUDirect 增加了相同 PCIe root complex 下 GPU 之间 Peer to Peer(P2P)Direct Access 和 Direct Transfer 的支持。
1.2 PCIe 与 NVLink
PCIe(peripheral component interconnect express)是高速串行计算机扩展总线标准,原名为"3GIO",由英特尔在 2001 年提出,旨在替代旧的 PCI、PCI-X 和 AGP 总线标准。它属于高速串行点对点双通道高带宽传输,所连接的设备分配独享通道带宽,不共享总线带宽,主要支持主动电源管理、错误报告、端对端可靠性传输、热插拔以及 QoS 等功能。
NVLink 是 NVIDIA 开发的总线及其通信协议,采用点对点结构、串行传输,是世界首项高速 GPU 互连技术。与传统 PCIe 方案相比,它能为多 GPU 系统提供更快速的替代方案——通过连接两块 NVIDIA 显卡,实现显存和性能扩展。
NVLink 高速互联主要有两种形式:
- 以桥接器(NVLink Bridge)的形式实现;
- 在主板上集成 NVLink 接口。
1.3 NVSwitch:把 NVLink 扩展到全机
借助 NVSwitch,NVLink 连接可在节点间扩展,创建无缝、高带宽的多节点 GPU 集群,有效形成"数据中心大小的 GPU"。通过在服务器外部添加第二层 NVSwitch,NVLink 网络可以连接多达 256 个 GPU,提供 57.6 TB/s 的多对多带宽。
为了解决 GPU 之间通讯不均衡问题,NVIDIA 引入 NVSwitch。NVSwitch 芯片是一种类似交换机的物理芯片(ASIC),通过 NVLink 接口将多个 GPU 高速互联到一起。设计上,NVLink 被加在每两组 GPU 之间,两组 NVLink 通过高速通道连接,NVSwitch 扮演每个 GPU 相互沟通时的通道切换角色。
迭代历史:
- 第一代(2018 年发布):台积电 12nm FinFET 工艺,18 个 NVLink 2.0 接口;
- 第三代(当前):台积电 4N 工艺(专为 NVIDIA 定制设计,相比普通 5nm 节点电源效率与性能更好、密度更高),每个 NVSwitch 芯片拥有 64 个 NVLink 4.0 端口,GPU 间通信速率可达 900GB/s。
1.4 GPU 服务器 PCIe 版和 SXM 版的区别
英伟达 GPU 卡间互连的插槽有 2 种:PCIe 口和 SXM 口。PCIe 是相对通用的协议,速度相对慢一些;SXM 是专门用来做卡间互连的,协议铺在电路板上,对 NVLink 原生支持更好,显存带宽也更高。两者都可以用 NVLink,但 SXM 是更好使用 NVLink 的方法。
SXM 架构是一种高带宽插座式解决方案,用于将 GPU 连接到 NVIDIA 专有的 DGX 和 HGX 系统。SXM 版 GPU 通过主板上集成的 NVSwitch 实现 NVLink 连接,不需要经过 PCIe 通信,能支持 8 块 GPU 卡互联互通。未阉割的 A100 是 600GB/s、H100 是 900GB/s,阉割过的 A800、H800 为 400GB/s。
PCIe 版 GPU 卡插到 PCIe 插槽上,可以和 CPU、同服务器其他 GPU 卡通信,也可以通过网卡与其他节点通信——但传输速度不快。想获得接近 SXM 的速度,可以使用 NVLink 桥接器,但和 SXM 不一样的地方是它只能实现 2 块 GPU 卡之间的通信。即 PCIe 版只有成对的 GPU 通过 NVLink Bridge 连接,通过 PCIe 通道进行数据通信,同时最新的 PCIe 网络带宽有 128GB/s 的限制。
1.5 典型 8 卡 A100 主机硬件拓扑
一台典型的 8 卡 A100 主机:
- 2 片 CPU(及两边的内存,NUMA);
- 2 张存储网卡(访问分布式存储、带内管理等);
- 4 个 PCIe Gen4 Switch 芯片;
- 6 个 NVSwitch 芯片;
- 8 个 GPU;
- 8 个 GPU 专属网卡。
1 | ┌─────────────────────────────────────┐ |
二、机器间通信技术:RDMA
计算数量巨大之后,多机多卡的计算/训练已经是常态,机器间通信是影响分布式训练效率的重要指标。
传统 TCP/IP 网络通信的问题在于:数据发送方需要将数据进行多次内存拷贝,并经过一系列网络协议的数据包处理工作;数据接收方在处理数据前同样如此。经过这些内存拷贝、数据包处理以及网络传输延时,server 间通信时延往往在毫秒级别——满足不了多机多卡场景的需求。
面对高性能计算、大模型训练这类 IO 高并发、低时延应用,传统 TCP/IP 软硬件架构的核心短板是:通过内核发送消息,存在很高的数据移动和数据复制开销。
RDMA(Remote Direct Memory Access,远程直接内存访问)就是为解决网络传输中服务器端数据处理延迟而产生的。它能直接通过网络接口访问内存数据,无需操作系统内核介入,允许高吞吐、低延迟的网络通信。
使用 RDMA 的主要优点:
- Kernel Bypass:旁路内核,CPU 卸载。实测中 40Gbps 流量 CPU 占有率只有 5%;
- Zero Copy:内存零拷贝,直接从网卡复制到应用内存,服务器内部处理时延低至 1~2 微秒;
- 因此 RDMA 可以实现服务器间的超低时延、超高吞吐量传输。
1 | 传统 TCP/IP: |
三、RDMA 的三种网络
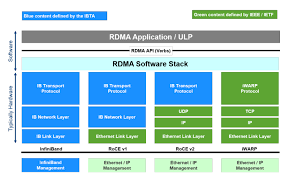
目前有三种 RDMA 网络:InfiniBand、RoCE(RDMA over Converged Ethernet)、iWARP。其中 InfiniBand 是专为 RDMA 设计的网络,从硬件级别保证可靠传输,技术先进但成本高昂;RoCE 和 iWARP 都是基于以太网的 RDMA 技术,使高速、超低延时、极低 CPU 使用率的 RDMA 技术得以部署在使用最广泛的以太网上。
三种网络的特点总结:
- IB(InfiniBand):基于 InfiniBand 架构的 RDMA 技术,由 IBTA(InfiniBand Trade Association)提出。搭建 IB 网络需要专用的 IB 网卡和 IB 交换机。设计之初就考虑了 RDMA,从硬件级别保证可靠传输,提供更高的带宽和更低的时延,但成本高;
- RoCE:基于以太网的 RDMA 技术,由 IBTA 提出。支持在标准以太网基础设施上使用 RDMA,但需要交换机支持无损以太网传输、服务器使用 RoCE 网卡。基于 Ethernet 做 RDMA,消耗的资源比 iWARP 少,支持的特性比 iWARP 多;
- iWARP:基于 TCP/IP 协议的 RDMA 技术,由 IETF 标准定义。支持标准以太网基础设施,但服务器需要使用支持 iWARP 的网卡。相比 RoCE,在大型组网的情况下,iWARP 的大量 TCP 连接会占用大量内存资源,对系统规格要求更高。
RoCE 协议有 v1 和 v2 两个版本:
- RoCE v1:基于以太网链路层实现的 RDMA 协议,数据包局限于同一个二层(L2)网络,不能跨越路由器(交换机需要支持 PFC 等流控技术,在物理层保证可靠传输)。适用于小规模和低延迟的局部网络环境;
- RoCE v2:将 RDMA 数据包封装在 UDP(端口 4791)和 IP 报文中,允许数据包跨越路由器和三层(L3)网络,引入 IP 解决了扩展性问题。适用于更大规模的网络和分布式数据中心环境。
“Converged Ethernet”(融合以太网)指的是在同一物理网络上支持多种流量类型(数据、存储、管理流量等),确保网络的高效利用和简化的架构。RoCE 通过在标准以太网上实现 RDMA 功能,使数据中心可以利用现有的以太网基础设施,而无需部署专用的 InfiniBand 网络。
四、InfiniBand 展开
4.1 带宽演进
InfiniBand(直译为"无限带宽",缩写 IB)是一个为大规模、易扩展机群而设计的网络通信技术协议,可用于计算机内部或外部的数据互连、服务器与存储系统之间的直接或交换互连、以及存储系统之间的互连。它最重要的特点就是高带宽、低延迟,因此在 HPC、高性能集群应用服务器和高性能存储中广泛应用。
InfiniBand 在物理层定义了多种链路速度,例如 1X、4X、12X,每个单独的链路是四线串行差分连接(每个方向两根线)。网络带宽从 SDR 一路发展到 NDR,速度基于 4x 链路:
| 代际 | 全称 | 单链路速率 | 4x 速率 |
|---|---|---|---|
| SDR | Single Data Rate | 2.5Gb/s | 10Gb/s |
| DDR | Double Data Rate | 5Gb/s | 20Gb/s |
| QDR | Quad Data Rate | 10Gb/s | 40Gb/s |
| FDR | Fourteen Data Rate | 14Gb/s | 56Gb/s |
| EDR | Enhanced Data Rate | 25Gb/s | 100Gb/s |
| HDR | High Data Rate | 50Gb/s | 200Gb/s |
| NDR | Next Data Rate | 100Gb/s | 400Gb/s |
InfiniBand 网络使用的线缆区别于传统以太网线缆和光纤线缆,互连产品包括 DAC 高速铜缆、AOC 有源线缆以及光模块。光模块用于光电信号转换,是交换机与设备之间传输的载体,按封装形式分类,常见的有 SFP、SFP+、XFP、SFP28、QSFP+、QSFP28 等。
4.2 IB 的软件栈
Mellanox OFED 是一个单一的软件堆栈,包括驱动、中间件、用户接口,以及一系列的标准协议:IPoIB、SDP、SRP、iSER、RDS、DAPL(Direct Access Programming Library),支持 MPI、Lustre/NFS over RDMA 等协议,并提供 Verbs 编程接口。Mellanox OFED 由开源 OpenFabrics 组织维护,软件堆栈承载在 InfiniBand 硬件和协议之上,通过协议和硬件进行有效的数据传输。
OpenSM 子网管理器:符合 InfiniBand 标准的子网管理器(SM),运行在 Mellanox OFED 软件堆栈上进行 IB 网络管理,管理控制流走业务通道,属于带内管理方式。OpenSM 包括子网管理器、背板管理器和性能管理器三个组件,提供非常完备的管理和监控能力,如设备自动发现、设备管理、Fabric 可视化、智能分析、健康监测等。
4.3 IB 组网:胖树为什么贵
InfiniBand 组网跟普通交换机不太一样,成本很高。如果希望网络中任何两个计算节点的网卡之间互相无损地通信,需要使用**胖树(Fat Tree)**网络拓扑。胖树主要有两层:
- 上面一层是核心层,不连任何计算节点,功能就是转发流量;
- 下面一层是接入层,接入各类计算节点。
1 | ┌──────┐ ┌──────┐ ┌──────┐ |
胖树拓扑成本高的主要原因是:每个汇聚交换机的一半端口要留给上层核心交换机。假如一个汇聚交换机有 36 个口,为了达到无损速率,只有 18 个口可以给计算节点用,剩下 18 个要连到上层的核心交换机上——要知道,任何一根线就是 1 万多块钱,如果达到无损,还要冗余地做这些连接。
IB 的供应方:Mellanox 在全球 InfiniBand 市场的占有率基本上是无敌的存在,DGX SuperPOD 中广泛应用 InfiniBand。
4.4 IB 网络通信硬件架构
通过服务器上的 PCIe 端口连接网卡,网卡通过 IB link 连接到交换机:
- HCA(Host Channel Adapter):主机通道适配器,将服务器与交换机相连,用于与其他服务器通信,可以多插几张——一台 8 卡主机配置了四张网卡;
- IB link(InfiniBand link):连接通道,可以是电缆或光纤,也可以是板上链路;
- Switch:交换机,以 NVIDIA Quantum-2 为例,支持 64 个 400G 和 128 个 200G IB 交换接口。
4.5 机器上看到的网卡
实际机器上的 ifconfig 输出——eth0(mtu 1500,业务网),lo(回环),以及 net1~net4(mtu 9000,即 RDMA/RoCE 网络,jumbo frame):
1 | $ ifconfig |
ibstatus 的输出更有信息量——同一台机器上混布了两种链路层的 IB 设备:
1 | $ ibstatus |
判读要点:link_layer: Ethernet 的设备 lid 为 0x0(以太网无 LID 概念),走 RoCE;link_layer: InfiniBand 的设备有真实的 base lid/sm lid(由 OpenSM 分配),走原生 IB。
五、RoCE 无损网络
5.1 PFC 与 DCQCN
为了实现高效操作,IB 和 RoCEv2 都需要在无损链路层上部署。为此,大部分部署使用基于优先级的流量控制(PFC)。PFC 允许以太网交换机通过强制暂停数据传输来避免缓冲区溢出。
但 PFC 是一种粗粒度机制:它在端口级别运行,对 flow 不进行区分,这可能导致拥塞扩散,性能不佳。最显著的问题就是需要设计一种拥塞控制协议,该协议可以在高速无损环境中高效运行,并且可以在 NIC 上实现——这就诞生了 DCQCN 流量控制算法,基于 RoCEv2 协议的端到端拥塞控制方案。
RoCE 网络的组成三要素:
- 支持 RDMA 的网卡(NIC):如 NVIDIA ConnectX 系列,支持硬件级 RDMA 功能;
- 支持数据中心桥接(DCB)的以太网交换机:交换机需要支持优先级流量控制(PFC)、增强传输选择(ETS)和数据中心桥接交换协议(DCBX)等 DCB 功能,确保无损以太网传输;
- RDMA 驱动程序和相关的网络管理配置工具:使用 ethtool、lldpad、dcbd 等工具配置 PFC、ETS 和 DCBX;安装 Mellanox OFED 驱动,以及 RDMA 协议库(librdmacm、libibverbs)。
5.2 RoCE 无损传输的问题
- 拥塞严重时会带来暂停发送的问题;
- 延迟增加;
- 暂停帧风暴(Pause Storm);
- 配置复杂,每个 Fabric 节点需要保持一致的无损配置;
- 受限制——比如大型网络,或客户的网络中,没有权限去配置无损。
5.3 与 NCCL 的映射
配置不同的 PFC 和 ECN 值以实现无损传输;设置不同的优先级队列,保证数据包可以在交换机上传输——映射到 NCCL 上就是 NCCL_IB_TC。
对于 RDMA_CM 应用设置 RoCE 模式:RDMA_CM 接口仅仅要求传递远端的 IP 地址,因此 RDMA_CM 决定了要使用的源 GID,并从表中获取该 GID。而表中可能包含多个 GID,必须按照 GID 类型来查询——这个查询的类型被定义为 RDMA_CM 模块的一个全局变量,这就是 NCCL_IB_GID_INDEX 的值。
六、平台对 RDMA 容器化做了什么
RDMA 本质还是网络,k8s 对网络有专门的 CNI 接口和插件。平台侧要解决的问题就一个:把 IB/RoCE 设备以容器可用的形式交付给训练任务。
6.1 IB 设备:rdma-shared-dev-plugin
对于 IB 设备,通过 rdma-shared-dev-plugin 插件将 IB 设备以共享资源的形式挂载到 GPU 容器中:
1 | { |
根据不同的 IB 网卡名字,分别切成了 1024 份,每个 GPU 任务(训练、开发机、推理)都挂载全部的 RDMA 设备。好处是简单易用,缺点是不隔离。
6.2 RoCE 场景:cnitool 屏蔽网卡差异
RoCE 场景的配置就复杂多了——RoCE 网卡的名字和型号非常多且繁杂,任何不匹配的地方都会导致 RDMA 网络不通。因此实现了一个 CNI 插件形式的 cnitool,具备解析 CNI 配置文件、并调用配置文件中对应类型 CNI 插件的功能,修改前后 CNI 插件的调用关系发生了变化。
节点 CNI 配置文件创建:节点上配置文件统一位于 /etc/cni/multus/net.d 目录下,文件名约定为 mizar-roce1 到 mizar-roce8。以 macvlan 为例,创建 /etc/cni/multus/net.d/mizar-roce1:
1 | { |
NAD 定义:修改后的 kustomization.yaml 引入 8 份 NAD:
1 | apiVersion: kustomize.config.k8s.io/v1beta1 |
其中 mizar-roce1.yaml 的内容为:
1 | apiVersion: "k8s.v1.cni.cncf.io/v1" |
任务配置 NAD 流程:crd jobs.batch.infini-ai.com 中配置关联的 NAD。
任务配置 NCCL 环境变量:通过 init 容器自动探测并注入:
1 | - export NCCL_IB_GID_INDEX=$(bash /tmp/mizar-roce/get_gid_index.sh) |
基于这样的插件,平台屏蔽了很多不同类型的网卡差异,透明地汇报给 k8s 容器,让用户启动训练任务时不用再关心底层细节——比如在 RoCE 的容器里启动分布式训练,和在 IB 场景下可以做到一模一样的脚本移植:
1 | mpirun --hostfile hosts --allow-run-as-root -bind-to none -map-by slot \ |
6.3 训练故障排查:node-perf-test
在大规模训练场景下,总会出现这样那样的问题导致训练变慢或中断。在容错机制上线之前,需要有方法排查出谁有问题。通常的做法是二分法——我们做了一个 node-perf-test 的小工具,可以一键进行二分排查坏节点:把训练作业的节点集合对半分组,各组内跑 NCCL 带宽测试,慢的那半继续对半,几轮下来就能把掉队节点揪出来。
七、One More Thing:GPUDirect RDMA
所谓 GPUDirect RDMA,就是计算机 1 的 GPU 可以直接访问计算机 2 的 GPU 内存。在没有这项技术之前,GPU 需要先将数据从 GPU 内存搬移到系统内存,然后再利用 RDMA 传输到计算机 2,计算机 2 的 GPU 还要做一次数据从系统内存到 GPU 内存的搬移动作。GPUDirect RDMA 技术进一步减少了 GPU 通信的数据复制次数,通信延迟进一步降低。
1 | 无 GPUDirect RDMA: |
需要注意的是,要想使用 GPUDirect RDMA,必须保证 GPU 卡和 RDMA 网卡在同一个 ROOT COMPLEX 下(即挂在同一条 PCIe 树上)——这也是配机器时网卡插槽位置有讲究的原因。
性能方面,Mellanox 网卡已经提供了 GPUDirect RDMA 的支持(既支持 InfiniBand 传输,也支持 RoCE 传输)。使用 OSU micro-benchmarks 在 Mellanox 的 InfiniBand 网卡上测试,可以看到使用 GPUDirect RDMA 后延时大大降低,带宽大幅提升。
小结
把整条链路串起来:
- 机器内:NVLink + NVSwitch 解决 GPU 全互联(SXM 版 900GB/s,PCIe 版只有成对 NVLink Bridge);GPUDirect 系列消除主机内存中转的拷贝;
- 机器间:TCP/IP 毫秒级时延撑不住训练,RDMA 以 Kernel Bypass + Zero Copy 把时延压到微秒级;三种网络选型——IB(性能最强、成本最高)、RoCE(以太网上的主流,需无损网络)、iWARP(TCP 系,大组网内存开销大);
- 无损网络:PFC 粗粒度流控 + DCQCN 端到端拥塞控制,配置复杂且全 Fabric 一致是 RoCE 落地的主要负担;
- 容器化交付:IB 走 rdma-shared-dev-plugin 共享挂载(简单但不隔离);RoCE 用 cnitool + 统一 NAD + init 容器注入 NCCL 变量,屏蔽网卡差异,让用户脚本在 IB/RoCE 之间无感移植;故障排查用 node-perf-test 二分定位坏节点;
- One More Thing:GPUDirect RDMA 让跨机 GPU 显存直达,前提是 GPU 和网卡同 root complex。
高性能网络容器化建设的本质,就是把从 PCIe 拓扑到 NCCL 环境变量的整条链路,封装成用户可见的只是一张网卡和一段训练脚本。
延伸资源
- 参考链接:
- 相关阅读:《RDMA 全链路拆解:从 ibv_reg_mr 到硬件,再到 AI 训练平台的实战落点》——本文 RDMA 软件栈落到底层就是那篇讲的那套 verbs 流程
- 相关阅读:《Macvlan 在大模型训练中的角色:为 Pod 提供共享 RDMA 通道》——本文 6.2 节 macvlan CNI 方案的展开
- 相关阅读:《IPoIB 与 pkey 子接口:InfiniBand 世界里的"IP 网卡 + VLAN"》——本文 4.2 节 OFED 协议栈中 IPoIB 的细节
- 相关阅读:《Spiderpool 多网卡 IPAM 深度解析:Underlay 网络缺的那块拼图》——多网卡 IPAM 与路由协调的生产级方案
- 相关阅读:《拆解那 11.9%:大规模训练集群的生产力损失度量与自动化治理》——本文 6.3 节 node-perf-test 排查坏节点的学术延伸:fail-slow 检测与 straggler 定位的系统化方案